把古籍做成 Anki 卡组,我顺手写了个生成器
最近迷上了读古籍。
不是那种从头啃到尾的读法——而是随手翻到哪句,念两遍,接着往下。《道德经》翻一句,「曲则全,枉则直,洼则盈」,念一遍,觉得对;再翻一句,「祸兮福之所倚」,再念一遍。半小时过去,脑子里已经过了十几句。
这件事之所以顺手,是因为工具对了。Anki 就是干这个的:它不要求你按顺序读完,只要求你今天看这一张,看完给你打个分,明天再问一遍。间隔重复的算法不用我操心,我只管喂它内容。
问题是——内容从哪来。
现成的卡组不够用
我先去找了一圈现成的古诗词卡组,用了两天,问题一个接一个:
排版难看。 打开一看,正文挤在屏幕中间一小块,字号忽大忽小,读起来眼睛累。
字段混乱。 有些卡组正面是「作者是谁」,背面塞了一整首诗的赏析;有些正面直接是上句,背面是下句——这个倒是对的——但混在同一个牌组里,我得靠自己辨认每张卡是哪类。
最要命的是没法增量更新。 Anki 靠 guid 识别笔记身份。你重新导入一个新版本的卡组,如果 guid 变了,Anki 就当成全新的笔记——我之前背了三个月积累的复习记录,全部清零。
第三条是硬伤。文本是会变的:注释会补、错字会改、赏析会写得更好。但如果每次更新都要付出「清空复习记录」的代价,那就只能忍着用一份将就的旧卡组。
干脆自己做
于是我想:既然需求这么明确,为什么不做一个生成器?
想法很简单——输入古籍原文,输出一个排版工整、可以反复增量更新的 .apkg。数据在浏览器里处理,不上传;生成的卡组自己攥着,想怎么改怎么改。
做出来是这个:AnkiMaker。
双卡型:背诵和理解是两种事
做完之后回头看,最满意的一个设计是它分两种卡。
背诵卡只问一句:上句是什么?答案给下句。比如:
上句:孤鸿海上来 下句:池潢不敢顾;
赏析卡反过来:正面给全诗,背面给赏析、译文、注释。
为什么必须拆成两种?因为它们该被复习的时机不一样。背句子是机械记忆,早上地铁上扫一遍就行;理解赏析是慢功夫,得坐下来读。这两类内容混在一张卡里,你没法安排复习——要么背诗的时候被赏析打断,要么读赏析的时候老想起那句还没背下来的诗。
分开之后,还有一个连带的好处:一条笔记最多出一张卡。
实现上靠的是字段空值判断,而不是标签。Anki 模板里能写条件渲染:
- 背诵卡要求「上句」非空才出卡 → 原文留空的背诵条目只出背诵卡
- 赏析卡要求「原文」非空才出卡 → 没有上句的整章条目只出赏析卡
两条线天然不串扰。我在道德经上用得最明显:81 章整章条文做成赏析卡,同时按标点把条文拆成 473 条背诵卡——一章两条线,同一本书,两种复习节奏。
稳定 guid:这是能不能用一年的分水岭
前面说的增量更新,具体是怎么做的?
Anki 识别笔记靠 guid 这个 8 字符字段。如果你给每条笔记一个稳定的 guid,那么重新导入新版卡组时,Anki 会认出「这是同一条笔记」,于是更新内容、保留复习记录。反过来,guid 变了就是新笔记,复习记录清零。
所以我给每条笔记设计了一个「身份证」:
guidSeed  "tang300:001:01"     ← 书名:序号:类型,稳定不变
   ↓ FNV-1a 64 位散列(BigInt 运算)
   ↓ 映射到 Anki 的 base91 字符集
   ↓ 取 8 个字符
guid      "Kx7mQ2pR"            ← 写进数据库,跨版本一致
关键在于 guidSeed 只依赖内容的身份(这是第几首诗的第几个背句),不依赖内容本身。将来我给《感遇》补了一句更准的注释,重新生成、重新导入——那条笔记还是原来那条,你的复习记录好好地在那儿。
这件事在 AnkiMaker 里是写死的约定:一旦发布就绝不能改。改了等于给所有笔记换身份,等于让所有人的复习记录作废。所以它在 README 里被单独列为「不能动的约定」的第一条。
牌组 id 同理,也是从牌组名稳定派生的,重复生成不会创建出「唐诗三百首 (1)」「唐诗三百首 (2)」这种垃圾。
牌组分到每一首诗
还有一处是用户提出来后我改的:原本背诵卡和赏析卡混在一个牌组里。
用户说:我想背诗的时候,只想看到诗;想读赏析的时候,只想看到赏析。
于是改成每首诗一个牌组:
唐诗三百首
└── 背诵
    └── 01 感遇(四首之一)
唐诗三百首
└── 赏析
    └── 01 感遇(四首之一)
代价是牌组数量暴涨——光唐诗三百首一部就生成了 642 个牌组,Anki 的牌组列表长得让人绝望。好处是每张牌都待在该待的地方,用起来非常干净。
我想了想,还是按用户的要求改了。工具好不好用,最终听用的人的。
真正的难点:让它能被 Anki 认出来
到这里都是数据结构的事。真正折磨人的是最后一步——Anki 认不认这个文件。
.apkg 本质是个 zip,里面装着一张 SQLite 数据库。听起来简单,但我第一次拿生成的包导入 Anki,迎接我的是:
JsonError: decoding deck config: missing field 'new'
一个一个坑踩过去,总结成一张表(都在 README 里):
| 报错 | 根因 | 修法 |
|---|---|---|
missing field 'new' |
牌组配置缺新卡参数 | 补齐 new / rev / lapse 三组 |
missing field 'rev' |
用了 Anki 2.1 的老键名 | 按 schema v11 改新键 |
decoding decks: JsonError |
decks 的 key 用了字符串名 | key 必须是数字 DeckId |
| 导入成功但全挤在一个牌组 | 解析失败时兜底返回了顶层牌组 | 建反向索引 |
最后一个坑最有意思:它不报错。程序以为自己成功了,Anki 也确实导入了——然后你打开一看,1980 条笔记全在同一个牌组里,分组完全没生效。不报错的错最费时间,因为你会怀疑是自己代码写错了。
现在生成时加了一道自检:下载前先回读一遍牌组配置结构,对不上就拒发并提示硬刷新缓存。这个行为有点倔,但比让用户拿到一个坏包、对着 Anki 报错发懵要好。
数据从哪来
6 部古籍,1980 条笔记,来源都要可查:
- 道德经(554 条)—— 维基文库《老子匯校版》,王弼本通行文字
- 唐诗三百首(640 条)—— Project Gutenberg #52323,蘅塘退士编,繁体
- 宋词三百首(566 条)—— 维基文库朱孝臧辑本,1924 年刊
- 金刚经(204 条)—— 鸠摩罗什译,按昭明太子 32 分则
- 心经(9 条)—— 玄奘译
- 逍遥游(7 条)—— 维基文库《莊子·逍遙遊》
都是公有领域文本,译文注释是自己整理的。
宋词三百首那 283 首的赏析,是我逐首写的题解——工程量不小,但这是这个项目里唯一不能自动化的部分。解析器能把原文变成结构化条目,「这首词好在哪」得有人说。
全在浏览器里跑
技术上没什么花活:sql.js(SQLite 的 WASM 版)在浏览器里建库,JSZip 打包成 zip。没有后端,没有 API,没有一行数据离开你的电脑。
这带来一个实际好处:断网能用。文本全部内置在页面加载的 JS bundle 里,不联网也能生成卡组。
代价是首次加载要下载 1MB 左右的数据 bundle 和 680KB 的 wasm。可以接受——毕竟换来的是「数据不出本机」这个卖点,而对一个要处理 1980 条文本的工具来说,这个承诺值得兑现。
现在能用了吗
能用。Anki 26.9.3 真实导入通过,双重校验都过了:
npm test—— 生成 zip → 解包 → 回读断言(表结构、字段分隔符、模板引用、guid 稳定性)verify_apkg.py—— 用 Python 的zipfile+sqlite3独立再读一遍,跟 Node 生成的结果对账
第二条是我特意加的。同一个实现自己验自己,容易变成自说自话。换一个完全不同的技术栈重新读一遍,才知道包是不是真对了。
页面长这样:
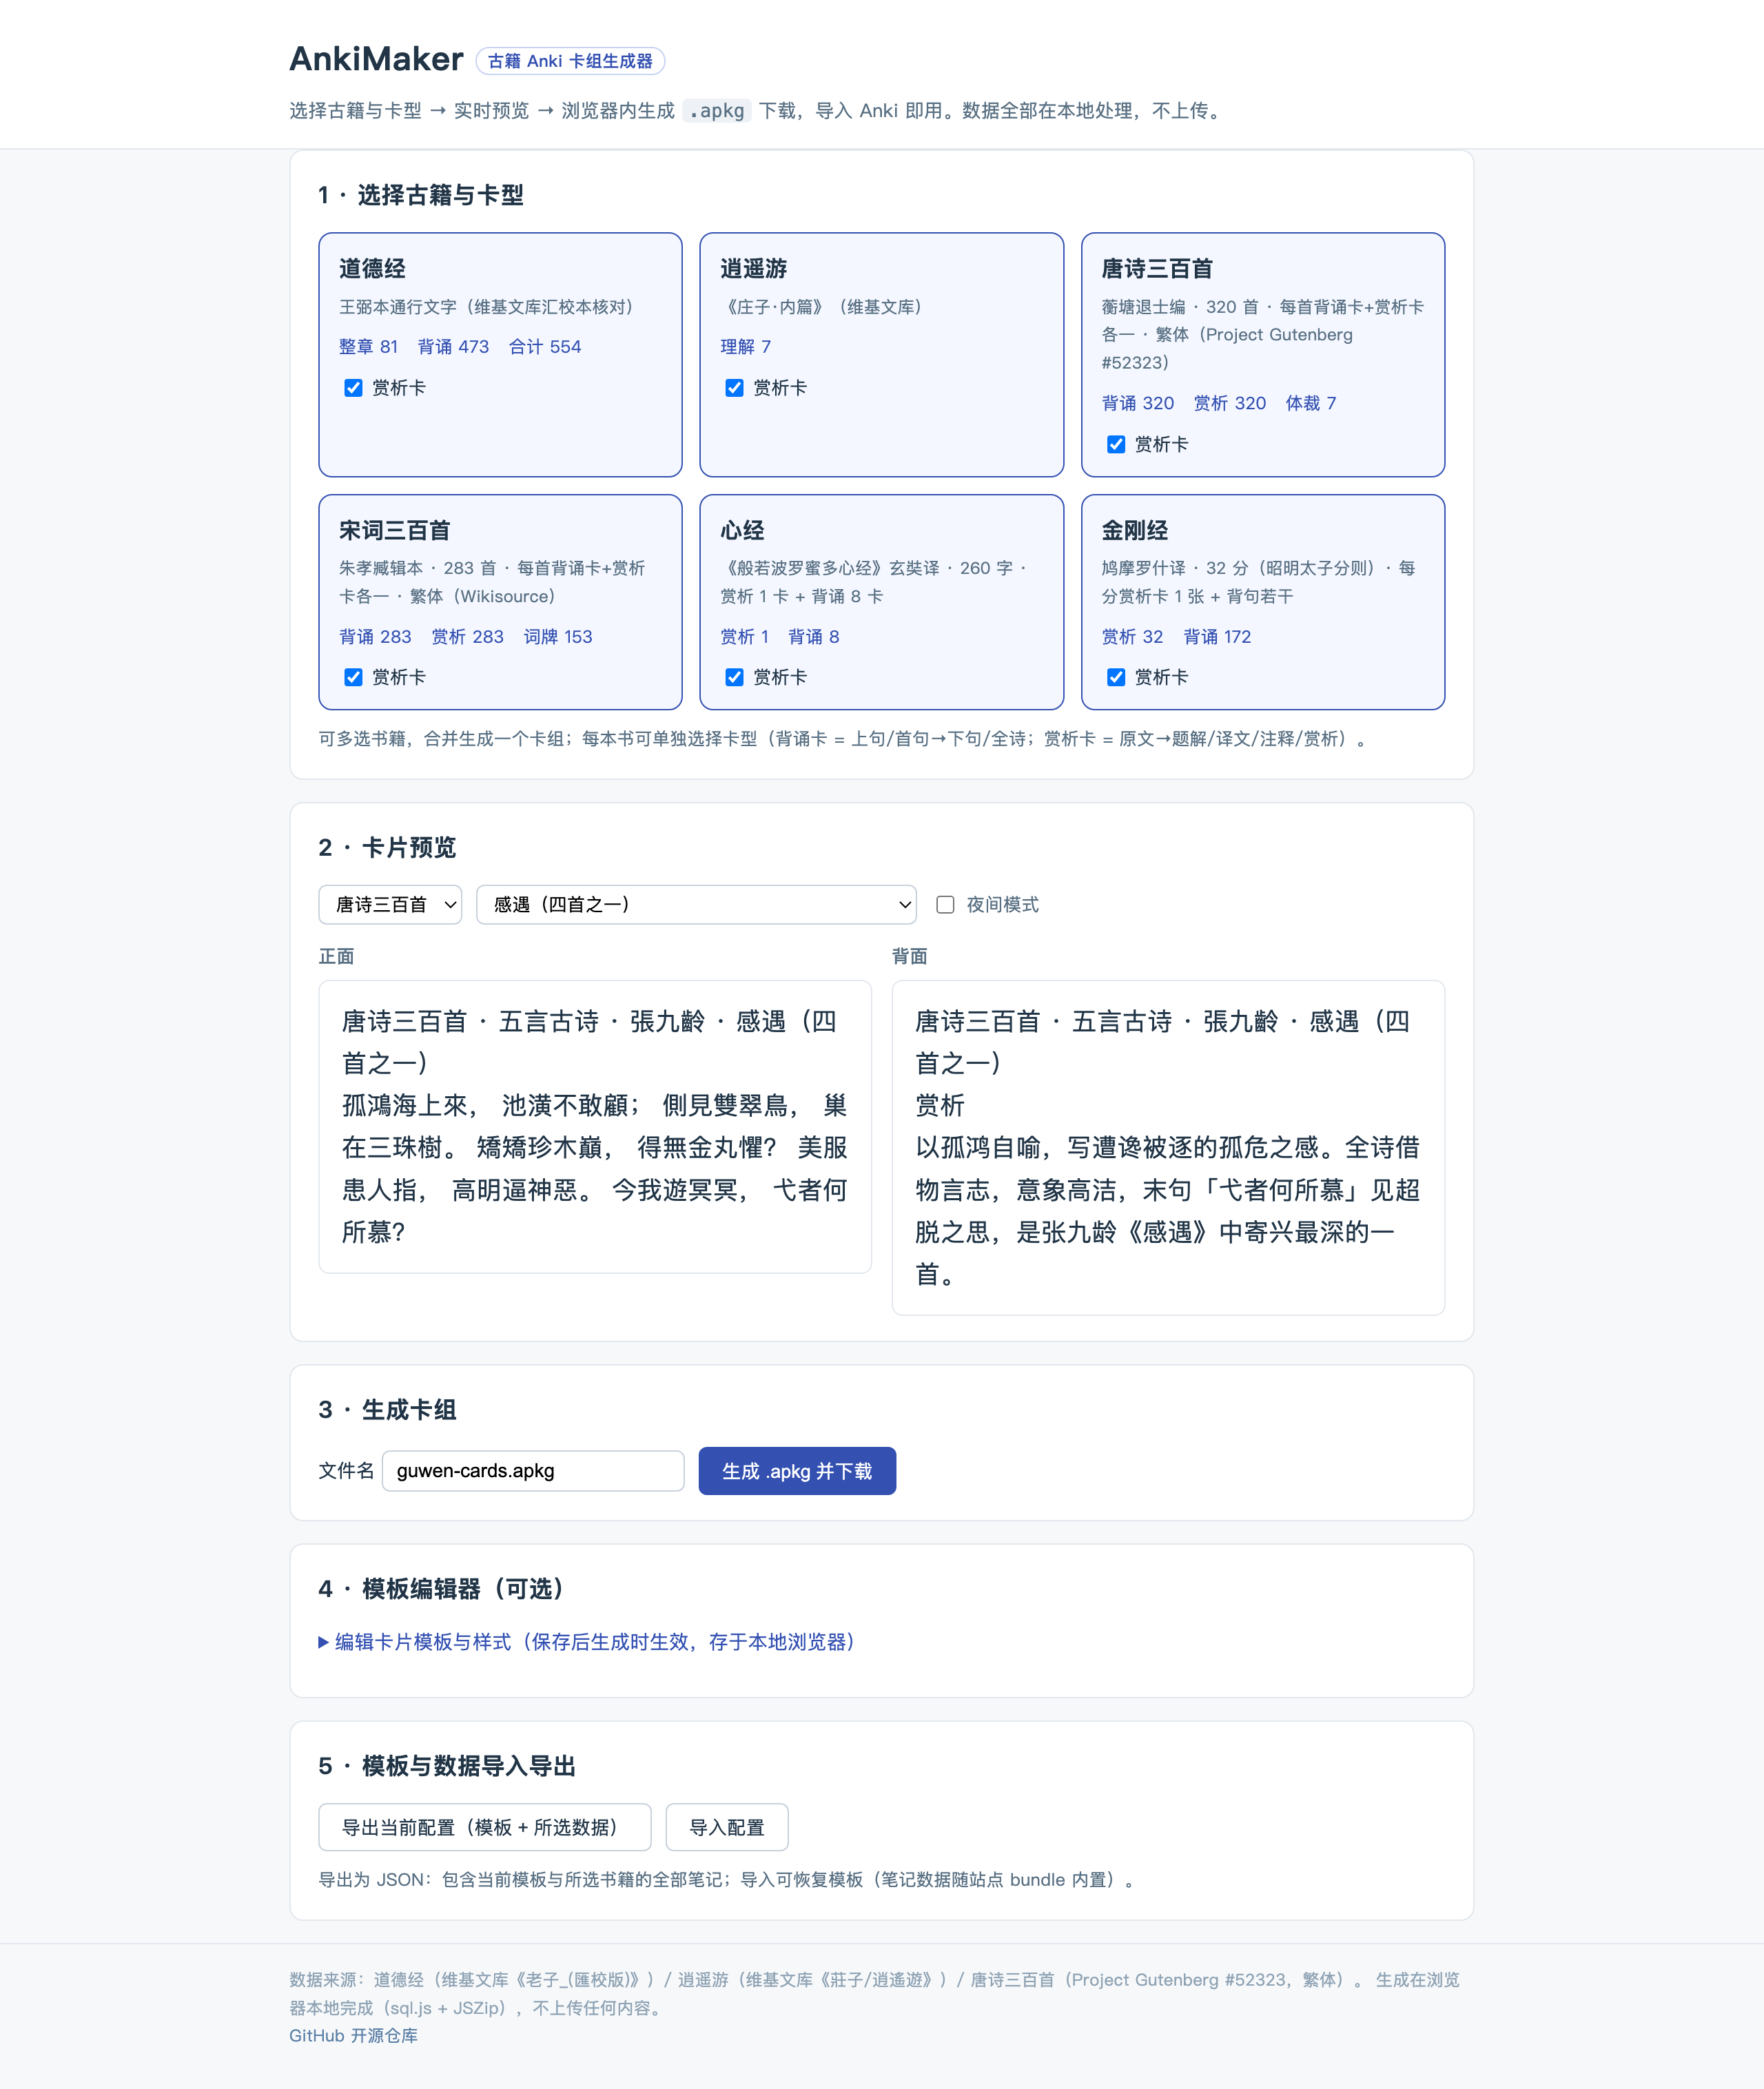
不想装环境的话,直接打开 kingsir.work/AnkiMaker 就能用——选书、点生成、下载 .apkg,全程在浏览器里,不注册也不上传数据。
一点感想
做完之后回头看,最有价值的其实不是那个生成器,是逼自己想清楚的一件事:
「我到底想怎么读这些古文?」
不是从《道德经》第一章读到第八十一章——那太重了,厚到没人真的读完。是随手翻到哪句,念两遍,接着往下。前者是任务,后者是习惯。
Anki 恰好是为后者设计的工具:碎片时间、内容随机、靠重复留下来。而一旦按这个目标去设计,卡型怎么分、牌组怎么放、guid 怎么稳,全都跟着清楚了。
工具适配使用方式,而不是反过来。中文博大精深,但一次能消化的量就那么点。把它切成两千张卡,反而是认真对待它的方式。
项目开源了,代码随便看随便用:AnkiMaker;想先试试的走在线版:kingsir.work/AnkiMaker。如果你也读古籍,欢迎提 issue 说你想加哪本书——加一本书的流程我写在 README 里了,照着做就行。
MIT 许可,随便拿去改。